RAG'e karar verdiniz. Asıl iş şimdi başlıyor
RAG mı fine-tuning mi sorusu her yerde cevaplanıyor. Kararın ardından kalan üç soru — anahtar, model seçimi ve bütçe — hiçbir yerde.

RAG mı fine-tuning mi, her yerde yazıyor; RAG dedikten sonra ne işlettiğiniz hiçbir yerde. Anahtar nerede duruyor, hangi uygulama hangi modeli kullanıyor, harcama nerede kesiliyor — üçü de o yazıların bittiği yerde başlıyor.
Bu yazı, kendi dokümanıyla çalışan bir LLM özelliği kurarken retrieval’ın etrafında kalan işin dört tasarım kararına nasıl döndüğünün hikâyesi. Kısa cevap şu: RAG’e karar vermek işin kolay yarısı; zor yarısı onu taşıyan gateway — uygulama ile sağlayıcı arasındaki geçit. Bu dördünü kuran şey Ragmux oldu.
Fine-tuning’i pahalı kılan şey GPU değil
Önce bir düzeltme, çünkü ilk gerekçem eksikti. “Model eğitmek ya da fine-tune etmek küçük bir ekip için imkânsız” diye düşünüyordum. Bunun yarısı artık doğru değil: bir LoRA fine-tune’unun GPU maliyeti bugün Winder.AI: RAG vs Fine-Tuning in 2026: A Decision Framework for LLM Teams çerçevesine göre 50 ilâ 500 dolar bandında ve sınıflandırma türü işler için birkaç yüz iyi örnek yetebiliyor.
Düşmeyen şey, o örnekleri üretmenin maliyeti. Aynı kaynak temiz, etiketli ve tekilleştirilmiş bin örneklik bir eğitim setinin çoğu zaman kıdemli bir mühendisin bir-iki haftasını aldığını söylüyor — yani pahalı olan hiçbir zaman GPU değildi, veriydi.
Ama benim için asıl belirleyici olan maliyet bile değil. Fine-tune edilmiş bir model dondurulmuş bilgi taşıyor: dokümantasyon değiştiğinde onu yeniden eğitmeniz, cevabın hangi belgeden geldiğini soramamanız ve temel modeli değiştirmek istediğinizde işi baştan yapmanız gerekiyor. RAG’i seçilir kılan şey ucuzluğu değil, kaynağın modelden ayrı durması: belgeyi değiştirirsiniz, cevap değişir; modeli değiştirirsiniz, belge yerinde kalır.
Kolay yarıyı bitirince kalanlar
Diyelim karar verildi ve iş yapıldı: doküman ayrıştırıldı, chunk’landı, gömüldü; arama çalışıyor. Bu noktada üç soru kalıyor ve üçü de retrieval’ın parçası değil:
- Sağlayıcı anahtarı nerede duruyor?
- Hangi uygulama hangi modeli kullanıyor?
- Harcama nerede kesiliyor?
Bu üçünü her uygulamanın kendi içinde çözmesi, aynı kodun uygulama sayısınca
kopyalanması demek — ve anahtarın uygulama sayısınca dağılması. Ragmux üçünü
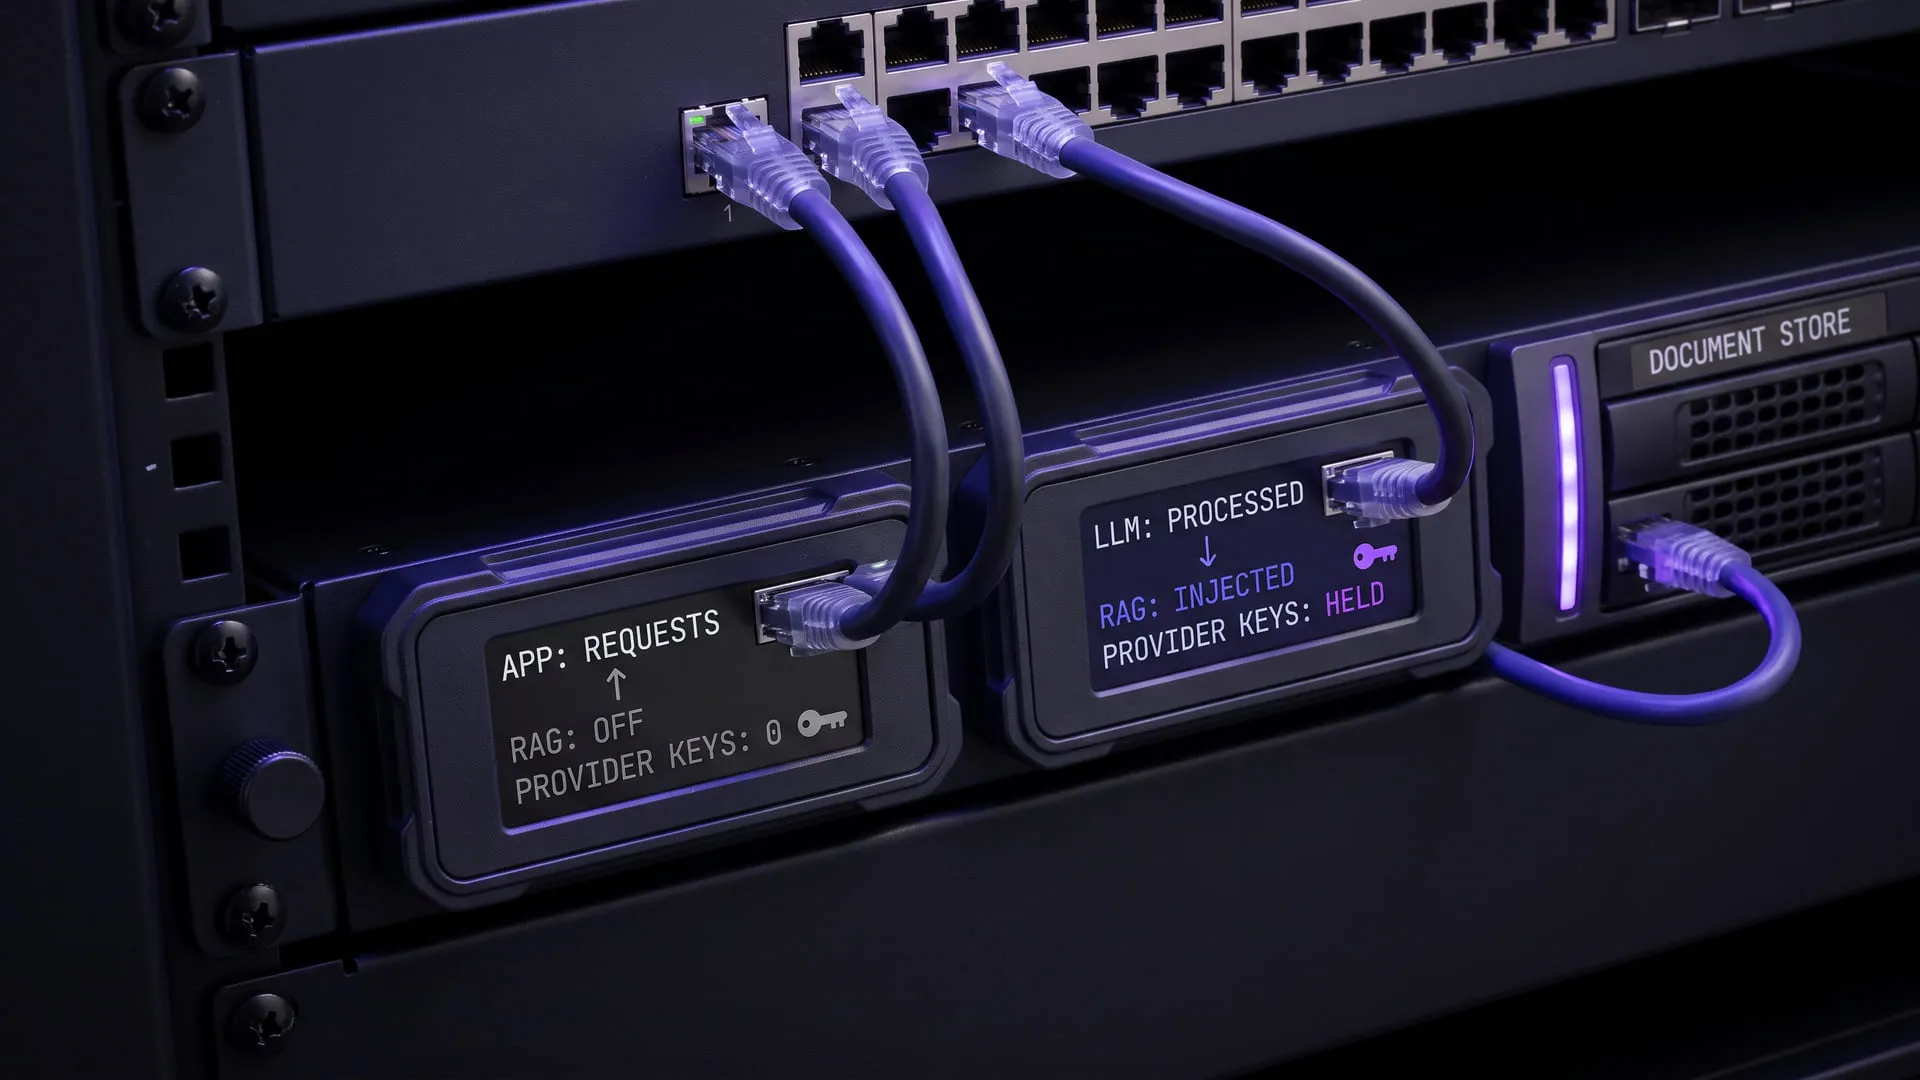
uygulamanın dışına, aradaki geçide taşıyor: uygulama tek bir OpenAI uyumlu uca
konuşuyor, resmî SDK’larda değişen tek şey base_url ile api_key oluyor.
Birinci karar: model alanı hiçbir şey seçmiyor
İsteğin içindeki model alanı yönlendirme yapmıyor. Hangi modele gidileceğini
projenin bağlantısı belirliyor; istemcinin yazdığı değer yalnızca cevapta ve
her akış parçasında olduğu gibi geri yankılanıyor, böylece o alanı karşılaştıran
SDK’lar kırılmıyor.
Bunun getirdiği şey, sağlayıcı kimlik bilgisinin uygulamaya hiç gitmemesi: sunucuda şifreli duruyor ve hiçbir arayüzde geri gösterilmiyor. Uygulamanın elinde yalnız projenin kendi anahtarı var; o anahtar sızarsa döndürdüğünüz şey sağlayıcı anahtarınız olmuyor.
Bedeli de açık: istemci artık model seçemiyor. Model seçimi bir dağıtım kararı olmaktan çıkıp bir yapılandırma kararına dönüşüyor — sağlayıcı değiştirmek yeniden deploy gerektirmiyor, ama bir uygulamanın “bu isteği şu modele gönder” demesi de mümkün olmuyor.
İkinci karar: bütçe parayla değil token’la kesiliyor
Her isteğin tahmini maliyeti hesaplanıyor ve panelde duruyor. Ama maliyet bilgidir: hiçbir istek bir para eşiğine ulaşıldığı için reddedilmiyor. Harcamayı sınırlamanın yolu token sınırlamak — proje başına dakikalık istek ve token tavanı, günlük ve aylık token bütçesi.
Bu bilinçli bir sınır. Bir isteğin gerçek maliyeti ancak sağlayıcı cevapladıktan sonra biliniyor; para üzerinden bir tavan uygulamak, tahminin üzerine tahmin koymak olurdu. Token da aynı sorunu daha küçük ölçekte taşıyor ve saklanmıyor: tek bir istek bütçeyi kendi boyutu kadar aşabiliyor, reddedilen de bir sonraki istek oluyor.
Reddedilen istek sağlayıcıya hiç gitmiyor, dolayısıyla hiçbir şeye mal olmuyor; ve limitler retrieval’dan önce kontrol ediliyor, yani sınırı dolmuş bir istemci bir embedding çağrısı bile harcamıyor.
Üçüncü karar: tek veritabanı, ikinci bir depo yok
Kullanıcılar, bağlantılar, projeler, dokümanlar, chunk’lar, vektörler, istek kayıtları ve kullanım sayaçları — hepsi pgvector’lü tek bir PostgreSQL’de. Redis yok, ayrı bir vektör veritabanı yok.
Bu bir sadelik tercihinden fazlası. Sayaç bir süreç değişkeni değil bir satır olduğu için, aynı veritabanına bakan birkaç kopya aynı bütçeyi paylaşabiliyor; bir kopyanın verdiği oturum çerezi diğerinde de geçerli oluyor; doküman işleme kopyalar arasında kiralamayla (lease) paylaştırılıyor. Yatay ölçekleme için yapılacak şey, ayrı bir koordinasyon katmanı kurmak değil, birkaç süreci aynı veritabanına bakacak şekilde başlatmak.
Bedeli şu: her şeyin tek bir PostgreSQL’e bağlı olması, o PostgreSQL’in de buna göre boyutlandırılması demek — ve varsayılan tek-container dağıtımı veritabanını kendi içinde barındırdığı için bilinçli olarak tek örneklik.
Dördüncü karar: retrieval başarısızlığı isteği düşürmüyor
Yeniden sıralama servisi cevap vermezse, arama arka ucu kullanılamıyorsa ya da bağlam getirilemiyorsa istek iptal edilmiyor. Olay loglanıyor, elde olan sıralama kullanılıyor ve istek bağlamsız devam ediyor. Dürüst olmak gerekirse cevapta bunu ayırt eden bir işaret yok: bağlam getirilemediğinde de eşleşme bulunamadığında da aynı “sıfır isabet” değeri dönüyor, fark yalnız logda.
Bunun tersi — “bağlam yoksa 500 dön” — daha dürüst görünüyor ama pratikte daha kötü: kullanıcı, cevabın biraz daha zayıf olması yerine hiç cevap alamamış oluyor. Burada seçim, sessizce yanlış cevap vermekle görünür biçimde eksik cevap vermek arasında değil; zayıf bir cevapla hiç cevap vermemek arasında — ve gerekçeyi cevap değil, log taşıyor.
Kendi kuralını çiğnediğini bulan gözden geçirme
Kayıtlı beş kararın üçü bir yayın öncesi gözden geçirmeden doğdu, ikisi de
kodla dokümanın çeliştiği yerlerden. Rol matrisi viewer’ı salt-okunur
anlatıyordu ama kod ona kendi gateway anahtarını üretme hakkı veriyordu — yani
bir “okuyucu” para harcayabiliyordu. Bir fiyat tablosu satırı, ücretli bir uca bakan bağlantıyı
“0,00 $” diye raporluyordu; eksik fiyat, sıfır fiyat gibi görünüyordu.
Beşinci karar ise aynı gün yumuşatıldı. Görsel indirme tavanına kiracı başına sert bir pay konmuştu. Ölçüm, tek projeli bir kurulumda — yani en yaygın hâlde — tavanın yarısının kalıcı olarak boş kaldığını gösterdi. Pay o gün esnetildi: kimse beklemiyorsa tek kiracı tavanın tamamını kullanabiliyor.
Bu üçünü yazmamın sebebi şu: bir aracın hangi kararları verdiğinden çok, o kararların nasıl denetlendiği ilgilendiriyor beni. Kendi dokümanıyla çeliştiğini bulabilen bir proje, bulamayan bir projeden daha güvenilir.
Bunun toplam bedeli
Kazandığım şey: sağlayıcı anahtarı tek yerde duruyor, hangi uygulamanın hangi modeli kullandığı bir yapılandırma satırı ve harcama proje başına kesiliyor. Yeni bir uygulama eklemek yeni bir anahtar dağıtmak değil, yeni bir proje açmak.
Ödediğim bedel: istemci model seçemiyor, bütçe parayla değil token’la kesiliyor ve tek bir istek bütçeyi kendi boyutu kadar aşabiliyor, her şey tek bir PostgreSQL’e bağlı ve bağlam getirilemediğinde cevap yine de üretiliyor.
Dördü de bir karardan çıktı ve dördünün de tersi savunulabilir. Bir geçit kurarken asıl soru “hangisi doğru” değil; hangi bedeli bilerek ödediğiniz.
Kurduğum yol ile kararların gerekçesi Labs kaydında, ürünün künyesi portfolyoda. Araç açık kaynak ve kendi sunucunuzda çalışıyor.
Kaynaklar
Bu konudaki deneyler
Uygulama ile sağlayıcı arasında duran, tek OpenAI uyumlu API sunan ve isteğe RAG bağlamını kendisi ekleyen self-hosted Go gateway.
Şu an ne yapıyor
Uygulamanın tek bir OpenAI uyumlu uca konuşmasını, isteğin hangi modele gideceğini ve — bir doküman havuzu bağlıysa — hangi dokümanlardan bağlam alacağını projenin ayarının belirlemesini sağlıyor. Sağlayıcı anahtarını uygulamalara dağıtmak istemeyen ve harcamayı proje başına sınırlamak isteyen herkes kendi sunucusunda çalıştırabilir.
Üretim veritabanına giden ad-hoc SQL'i onaya, maskelemeye ve değiştirilemez bir ize bağlayan self-hosted portal; QueryProxy ürününe dönüştü.
Şu an ne yapıyor
Geliştiricinin yazdığı SQL'i üretim veritabanında doğrudan değil, bir onaydan geçirerek çalıştırıyor; sonuçlar diske yazılırken maskeleniyor ve her istek değiştirilemez bir kayda düşüyor. Prod erişimi tek kişide toplanmış ekipler kurabilir.
Yorumlar
Yorum yapmak için GitHub hesabınızla giriş yapmanız yeterli. Yorumlar GitHub Discussions üzerinde saklanır.