Üçüncü MCP sunucusu makuldü, sonrakiler değildi
Ajana projenin dokümanını vermek için MCP doğru cevaptı. Proje sayısı artınca sunucuların kendisi bakım gerektiren bir yüke dönüştü.

Her projeye ayrı bir MCP sunucusu kurmak ilk üçünde makul görünüyordu. Sonra sunucular birbirinden ayrı yaşamaya başladı: hangisi hangi dizini indeksliyordu, hangisi en son ne zaman senkronlanmıştı, hangisinin kendi chunk’lama kodu vardı.
Bu yazı, geliştirme ortamımdaki onlarca projenin dokümanını ajanlara açarken karşılaştığım dört gereksinimin dört tasarım kararına nasıl döndüğünün hikâyesi. Kısa cevap şu: ajana bağlam vermenin doğru birimi proje başına bir sunucu değil, proje başına bir uç. Bu dördünü kuran şey Contextator oldu.
Sorun token faturası değildi
İlk teşhisim yanlıştı. Ajanın her oturumda projeyi baştan keşfetmesini bir maliyet kalemi sanıyordum: dosyaları geziyor, okuyor, aynı yapıyı tekrar tekrar çıkarıyor ve bunun bir faturası var.
Fatura gerçek ama asıl mesele o değil. Keşfin bittiği yerde model durmuyor. Aradığı şeyi bulamadığında bir sonuç üretmeye devam ediyor ve boşluğu varsayımla dolduruyor. Bu sessiz oluyor: çıktıda “bu dosyayı bulamadım” diye bir satır olmuyor, makul görünen ama dayanaksız bir cevap oluyor. Token faturasını ayın sonunda görürsünüz; varsayımı ancak o kodu okuyan biri yakalarsa görürsünüz.
Doğru cevap, modelin araması gereken yeri ona vermek — yani MCP. Zor olan protokol değil.
Zor olan, aynı şeyi onlarca kez kurmak
Proje başına bir MCP sunucusu yazmak ilk seferinde birkaç saatlik iş. İkincisinde kopyala-yapıştır. Üçüncüsünde hâlâ makul.
Beşincisinde şunu fark ediyorsunuz: her yeni proje aynı chunker’ı, aynı embedding döngüsünü ve aynı artımlı indeksleyiciyi bir kez daha yazmak demek — ve sonrasında hepsini ayrı ayrı sürdürmek. Biri yeni bir dosya tipini destekliyor, diğeri desteklemiyor. Biri silinen dosyaları indeksten düşürüyor, diğeri düşürmüyor. Hangisinin ne zaman senkronlandığını görmek için her birine ayrı bakmak gerekiyor.
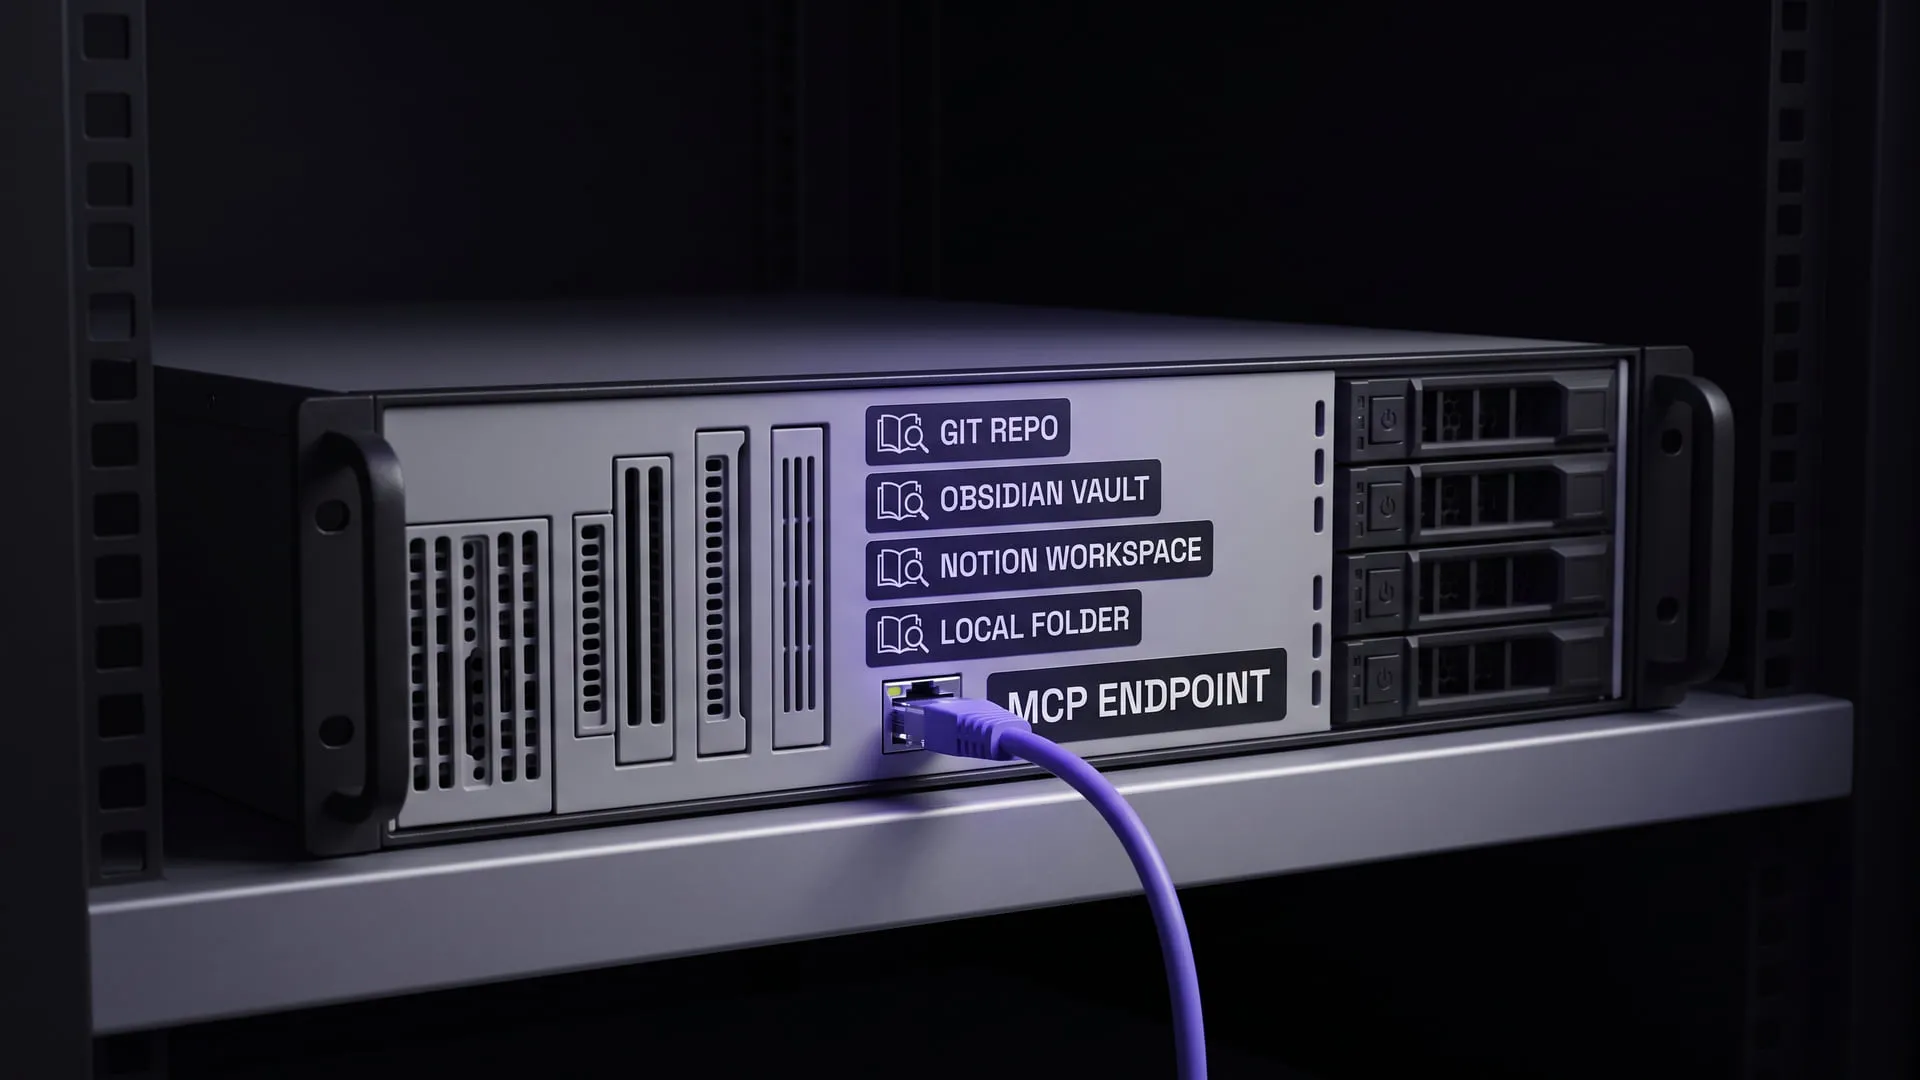
Üstüne bir de şu var: bir projenin dokümanı tek bir yerde durmuyor. Bir kısmı depoda, bir kısmı Notion’daki el kitabında, bir kısmı bir Obsidian kasasında, bir kısmı paylaşılan sürücüdeki bir arşivde. Tek klasör indeksleyen bir araç, önce bir insanın hepsini tek yere toplamasını bekliyor — ki bu hiç olmuyor.
Contextator bu tekrarı tek kuruluma indiriyor. Bir proje, kaynaklarının
toplamı: bağlı bir klasör, bir git deposu (ya da onun tek bir alt dizini),
yüklenmiş bir arşiv, bir Obsidian kasası, bir Notion çalışma alanı. Hepsi tek
uçta birleşiyor ve her kaynak kendi adının altına monte ediliyor, böylece bir
doküman handbook/install.md diye okunuyor.
Birinci karar: yalıtım bir ayar değil, adresin kendisi
Her proje kendi URL’ini alıyor: /mcp/<proje>. /mcp/billing’e bağlı bir
istemci /mcp/mobile’ı hiç görmüyor.
Alternatifi tek bir uç açıp isteğe bir project parametresi koymaktı. O
tasarımda yalıtım, ajanın doğru parametreyi göndermesine bağlı kalırdı — ve bir
modelin argüman seçimine dayanan gizlilik, gizlilik değildir.
Bedeli açık ve peşinen kabul edilmiş: projeler arası arama yok. “Şu deseni hangi projede kullanmıştım?” diye tek soruda bakamıyorsunuz. Bu bir eksik değil, kararın kendisi: bakılabilseydi her arama sessizce her projeye yayılırdı.
İkinci karar: çalışmak için anahtar istememesi
Embedding’ler varsayılan olarak makinenin CPU’sunda üretiliyor. Sebep maliyetten önce şu: sürekli sorgulanmak üzere kurulmuş bir aracın çalışmak için bir API anahtarı istemesi, “kendi sunucunda çalışır” vaadini baştan bozar. Birkaç ortam değişkeniyle OpenAI embedding’lerine geçmek mümkün, ama varsayılan yol dışarıya hiç çıkmıyor.
Bedeli ilk açılışta ödeniyor: model indiriliyor ve container’ın ayağa kalkması birkaç dakika sürüyor. Sonraki başlangıçlar saniyeler sürüyor. Kurulumu tek komuta indirmek için PostgreSQL ile uygulama aynı imajda duruyor — “tek container tek süreç” ortodoksisinden bilinçli bir sapma ve bedeli de bu.
Üçüncü karar: aramanın iki dizine birden sorması
Bir cümle modelinin HALYARD_DISPATCH_TIMEOUT diye bir şeyden haberi yok.
Yalnız çevresindeki kelimelerden haberi var. Oysa dokümantasyonda aranan şeyin
önemli bir kısmı tam olarak budur: bir sabit adı, bir hata kodu, bir bayrak.
O yüzden her chunk hem vektör hem tam metin dizininde duruyor ve bir arama iki listeyi birden alıp sıralamalarını birleştiriyor. Skorları değil sıralamaları — çünkü skorların ağırlıklandırılması, embedding modeli her değiştiğinde yeniden öğrenilmek zorunda kalırdı; sıralamalar model değişimini olduğu gibi atlatıyor.
Görünür bedeli şu: sonuçtaki benzerlik skoru artık o sonucun neden orada olduğunu açıklamıyor.
Dördüncü karar: bulunamayanı söylemek
Arama hiçbir şeyi alaka eşiğinin üstüne çıkaramadığında en kötü sonucunu döndürmüyor; “iyi bir eşleşme yok” diyor ve dokümanları listeleyen araca yönlendiriyor.
Aynı disiplin indekslemede de var: metin katmanı olmayan taranmış bir PDF indekslenmiyor, reddediliyor. Çünkü fark edilmeyen başarısızlık, bir doküman üretentir — boş metin indekslenir, proje artık var olan, listelenen, hiçbir şeyle eşleşmeyen ve açıldığında boş görünen bir dokümana sahip olur.
Ölçülüp bırakılan sınır
Dürüst olmak gerekirse çalışmayan bir şey var: diller arası arama. Türkçe sorulan bir sorunun cevabı İngilizce bir sayfada duruyorsa çoğunlukla bulunmuyor.
Bu bir yapılacak iş değil, kapatılmış bir karar. İki çözüm denendi. Önce hibrit arama: tanımlayıcıları kurtardı, tek bir doğal dil sorusunu kurtarmadı. Sonra çok dilli bir yeniden sıralama modeli: diller arası isabeti yükseltti ama bir aramayı milisaniyelerden saniyelere çıkardı ve sıradan sorulardan bir kısmının birinci sıradaki cevabını götürdü. İkisi de ölçüldü, ölçümler depoda duruyor.
Gerçek çözüm ikinci bir çeviri-eğitimli model olurdu: dört kat indirme, ikinci bir vektör sütunu ve her kurulumda tam yeniden indeksleme. Bir doküman sunucusu için bu fiyat ödenmedi. O yüzden kayıt “yapılacaklar” listesinde değil, dokümantasyonda duruyor — ve okuyucunun corpus’u gerçekten iki dilliyse, bu arama biçimi de kritikse, bu kayıt onun başka bir araç seçmesi için bir sebeptir.
Bunun toplam bedeli
Kazandığım şey şu: yeni bir projenin dokümanını ajana açmak artık bir sunucu yazmak değil, panele bir kaynak eklemek. Kaynaklar değiştiğinde yalnız değişen dosya yeniden gömülüyor, silinen dosyanın dokümanları düşüyor.
Ödediğim bedel de açık: projeler arası arama yok, ilk açılış model indirmesi bekliyor, tek container tek süreç değil ve iki dil arasında arama yapmıyor. Dördü de bir karardan çıktı ve dördü de geri alınabilir değil — bir aracın ne yaptığını bilmek kadar, ne yapmadığını bilmek de kurulum kararının parçası.
Kurduğum yol ile kararların gerekçesi Labs kaydında, ürünün künyesi portfolyoda. Araç açık kaynak ve kendi sunucunuzda çalışıyor.
Bu konudaki deneyler
Her projeye kendi MCP ucunu açan, dokümanı kendi sunucunda tutan çok kiracılı doküman sunucusu; embedding'ler CPU'da üretiliyor.
Şu an ne yapıyor
Bir projenin klasörünü, git deposunu, Obsidian kasasını ya da Notion çalışma alanını tek bir MCP ucunun arkasında aranabilir kılıyor; ajan dokümana ulaşırken veri üçüncü tarafa gitmiyor. Docker ile kurup panelden yöneten herkes kendi sunucusunda çalıştırabilir.
Üretim veritabanına giden ad-hoc SQL'i onaya, maskelemeye ve değiştirilemez bir ize bağlayan self-hosted portal; QueryProxy ürününe dönüştü.
Şu an ne yapıyor
Geliştiricinin yazdığı SQL'i üretim veritabanında doğrudan değil, bir onaydan geçirerek çalıştırıyor; sonuçlar diske yazılırken maskeleniyor ve her istek değiştirilemez bir kayda düşüyor. Prod erişimi tek kişide toplanmış ekipler kurabilir.
Yorumlar
Yorum yapmak için GitHub hesabınızla giriş yapmanız yeterli. Yorumlar GitHub Discussions üzerinde saklanır.